Индикаторы здоровья
Индикатор здоровья (Health Indicator) — это показатель, который используется для оценки состояния системы, приложения, сервиса или инфраструктуры. Он помогает определить, насколько хорошо работает система, и выявить потенциальные проблемы.
Основные характеристики индикаторов здоровья:
- Простота: Индикатор должен быть легко интерпретируемым.
- Релевантность: Он должен отражать ключевые аспекты работы системы.
- Достоверность: Индикатор должен точно отражать состояние системы.
- Оперативность: Данные должны обновляться в реальном времени или с минимальной задержкой.
Примеры индикаторов здоровья
1. Для веб-приложений:
- Доступность (Availability): Процент времени, когда приложение доступно для пользователей.
- Время ответа (Response Time): Среднее время, за которое приложение обрабатывает запросы.
- Частота ошибок (Error Rate): Количество ошибок (например, 5xx) на общее количество запросов.
- Загрузка CPU и памяти: Использование ресурсов сервера.
2. Для баз данных:
- Количество активных подключений: Число текущих подключений к базе данных.
- Задержка запросов (Query Latency): Время выполнения запросов.
- Размер базы данных: Использование дискового пространства.
3. Для микросервисов:
- Healthcheck: Результат проверки работоспособности сервиса (например, HTTP-запрос на
/health). - Пропускная способность (Throughput): Количество обработанных запросов в единицу времени.
- Задержка (Latency): Время обработки запросов.
4. Для инфраструктуры:
- Состояние серверов: Работают ли серверы (например, ping или статус в мониторинговой системе).
- Использование сети: Количество входящего и исходящего трафика.
- Свободное место на диске: Достаточно ли места для хранения данных.
Как используются индикаторы здоровья?
- Мониторинг - визуализация индикаторов здоровья на дашбордах и в CMDB.
- Оповещения - отправка уведомлений в Telegram или по E-mail.
Реестр индикаторов здоровья
Реестр индикаторов здоровья находится на странице Главная / Настройки / Мониторинг / Индикаторы здоровья.
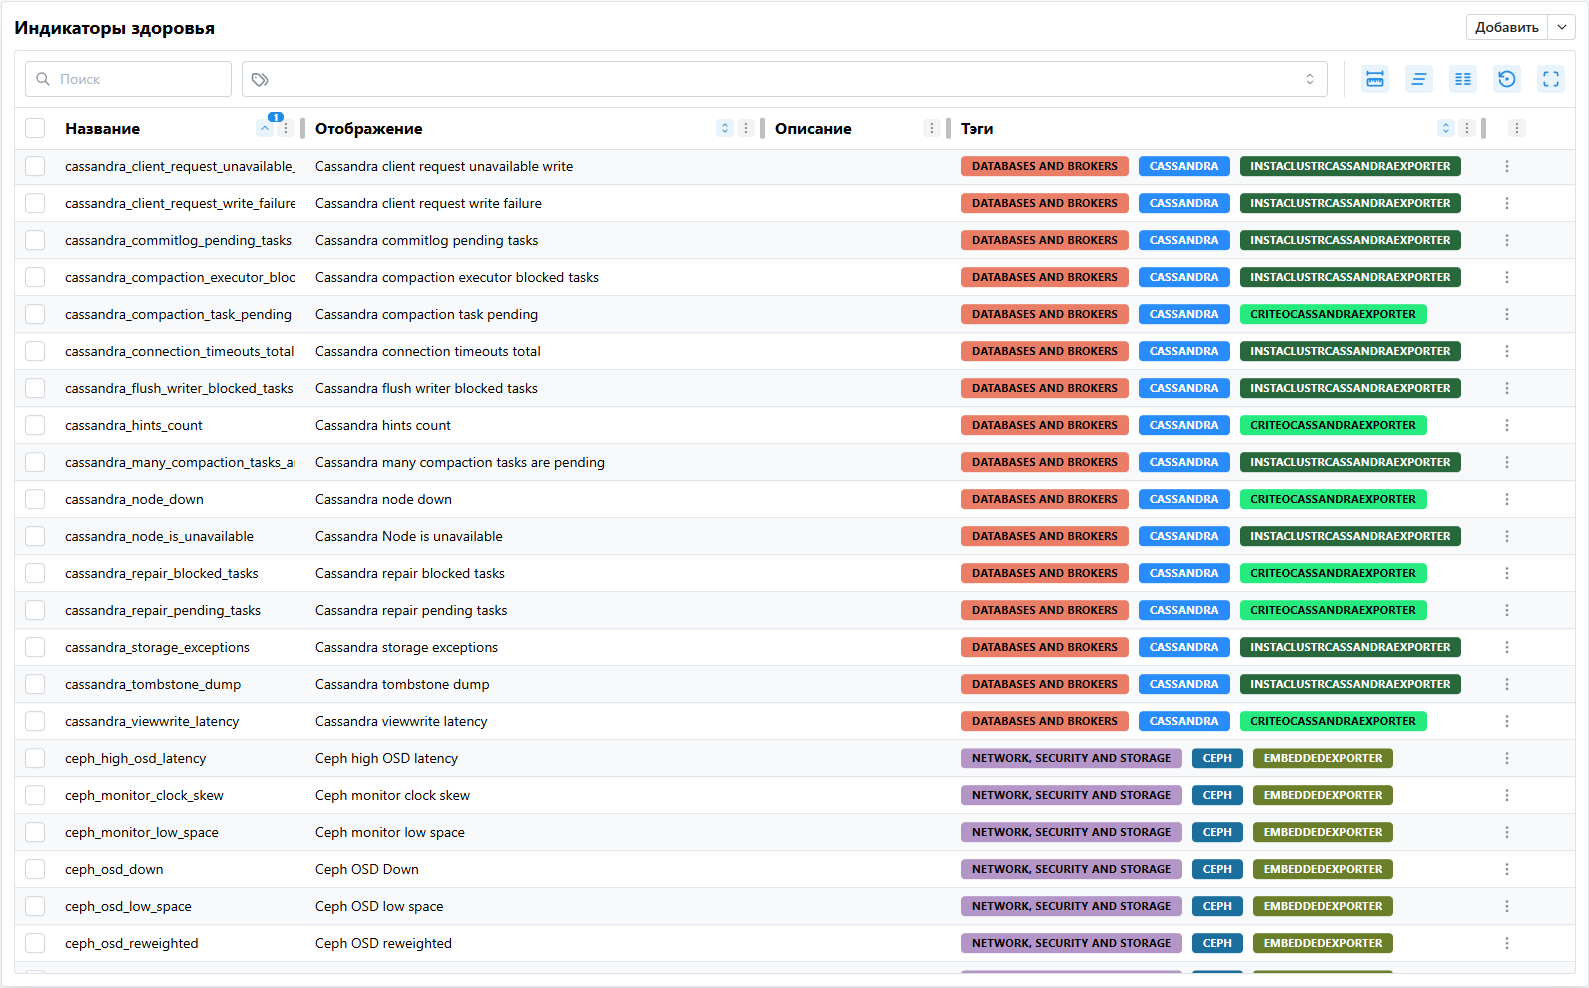
Реестр содержит индикаторы здоровья, которые могут быть привязаны к конкретным КЕ по средствам шаблонов мониторинга. Индикатор здоровья помимо описательной части (название, отображение, описание), может содержать правило генерации тревоги, на основе собранных метрик.
Структура конфигурации индикатора здоровья:
- alert - название алерта
- expr - выражение на языке PromQL, которое определяет условие для срабатывания алерта
- for - время, в течение которого условие должно быть истинным, прежде чем алерт сработает.
- labels - дополнительные метки, которые добавляются к алерту (например,
severity: '[[ severity.CRITICAL ]]'). - annotations - дополнительная информация, которая отображается в уведомлениях (например,
summaryиdescription).
Изменение конфигурации индикатора здоровья не приводят к обновлению кофнигуарциии в шаблонах мониторинга. Кофнигуарция используется в качестве шаблона при создании индикатора метрики.
При удалении индикатор будет исключен из реестра. Удаление индикатора здоровья повлечет за собой удаление всех настроенных индикаторов на объектах контроля, связанных с удаляемым типом.
Уровни критичности (severity)
Параметр severity определяет уровень критичности состояния индикатора здоровья. Он указывается в блоке labels правила алертинга.
Значение можно задать числовым кодом:
labels:
  severity: 5
или соответствующей шаблонной константой:
labels:
  severity: '[[ severity.CRITICAL ]]'
Допустимые значения:
| Числовое значение | Шаблонная константа | Значение |
|---|---|---|
2 | [[ severity.OK ]] | Норма — индикатор работает штатно, проблемы отсутствуют. |
3 | [[ severity.WARNING ]] | Предупреждение — обнаружено отклонение, требующее внимания. |
4 | [[ severity.ERROR ]] | Ошибка — нормальная работа контролируемого объекта нарушена. |
5 | [[ severity.CRITICAL ]] | Критическое состояние — обнаружена критическая проблема, требующая немедленного реагирования. |
Числовое значение и соответствующая ему шаблонная константа равнозначны. Например, 5 и [[ severity.CRITICAL ]] задают один и тот же уровень критичности.
Использование других значений не поддерживается. Имена шаблонных констант необходимо указывать в верхнем регистре.
Привязка индикатора к узлу TQL
Индикатор здоровья привязывается не к КЕ напрямую, а к узлу TQL-запроса шаблона мониторинга: индикаторы создаются на всех экземплярах КЕ, которые этот узел возвращает.
У каждого узла TQL есть номер — натуральное число, уникальное в пределах запроса. В файле экспорта шаблона это
поле filterId узла, в конфигурации привязки — node_id. Номер видно на карточке узла в редакторе TQL, и он же
участвует в ссылке на узел в шаблонах Jinja: <название_ТКЕ>_<номер>, например host_2. Без номера нельзя написать
ни правило ci_hint, ни
шаблон формирования таргета метрики.
Номер освобождается при удалении узла и может быть выдан следующему добавленному узлу. После изменения структуры TQL проверяйте привязки индикаторов и метрик.
Отображение узла в интерфейсе
Узел показывается одной строкой: сначала название, затем номер.
Экземпляр PostgreSQL ID: 4
Название выбирается по первому подходящему правилу:
- псевдоним узла, если он задан в редакторе TQL;
- название ТКЕ из реестра типов КЕ;
- отображаемое имя, сохранённое в шаблоне (
display_name) — снимок названия ТКЕ на момент создания узла.
Номер отображается всегда, в том числе когда название получить не удалось. Две причины разведены, потому что чинятся по-разному:
| Что показано | Что произошло | Что делать |
|---|---|---|
узел не определен + номер | ТКЕ узла отсутствует в реестре типов КЕ | восстановить ТКЕ или перепривязать индикатор к другому узлу |
узел удалён из TQL + номер | узла с таким номером больше нет в TQL шаблона | вернуть узел в TQL или удалить привязку |
Название и номер показываются одинаково во всех местах, где встречается узел: в поле «Узел TQL» формы привязки (и в раскрытом списке, и после выбора), во вкладках источников расчётного индикатора, в таблицах индикаторов и метрик, а также в меню вставки ссылок на узлы в редакторе правил. В раскрытом списке рядом с названием дополнительно показывается системное имя ТКЕ — та часть, из которой собирается ссылка на узел. Поиск по списку работает и по названию, и по номеру.
Источники расчётного индикатора
Источники расчётного индикатора берутся с узлов, которым в СРМ соответствуют КЕ, смежные с КЕ узла самого индикатора. Каждый выбранный узел-источник добавляется отдельной вкладкой, подписанной названием и номером узла: два узла одного ТКЕ различаются только номером.
Поле «Фильтр» ограничивает источник конкретными привязками. Такие привязки могут принадлежать другим шаблонам мониторинга, поэтому подписаны они целиком — названием шаблона, названием узла и его номером в этом шаблоне:
Самомониторинг PAMIR → Сервер приложений ID: 5
Номер здесь относится к TQL того шаблона, которому привязка принадлежит, и с нумерацией редактируемого шаблона не связан. Пустое поле «Фильтр» означает, что источником будут все КЕ выбранного узла, на которых настроен указанный индикатор.
Типы индикаторов здоровья
В зависимости от источника данных индикаторы здоровья бывают следующих типов:
- Индикатор метрики:
- Источник данных - метрика
- Метрика в обязательном порядке должна содержать лейбл
ci_id
- Индикатор метрики (ci_hint)
- Источник данных - метрика
- Метрика в обязательном порядке должна содержать лейбл
ci_hint
- Статус КЕ (static)
- Источник данных - конфигурация КЕ в CMDB
- Сбор данных не выполняется, статус задается в привязке
- Событие (event)
- Источник данных - события из внешней системы
- Событие в обязательном порядке должно содержать метки
hi_hintиci_hint
- Расчетный индикатор
- Источник данных - индикаторы здоровья любого типа
Индикатор метрики
Индикатор метрики — позволяет оценивать состояние КЕ на основе метрики.
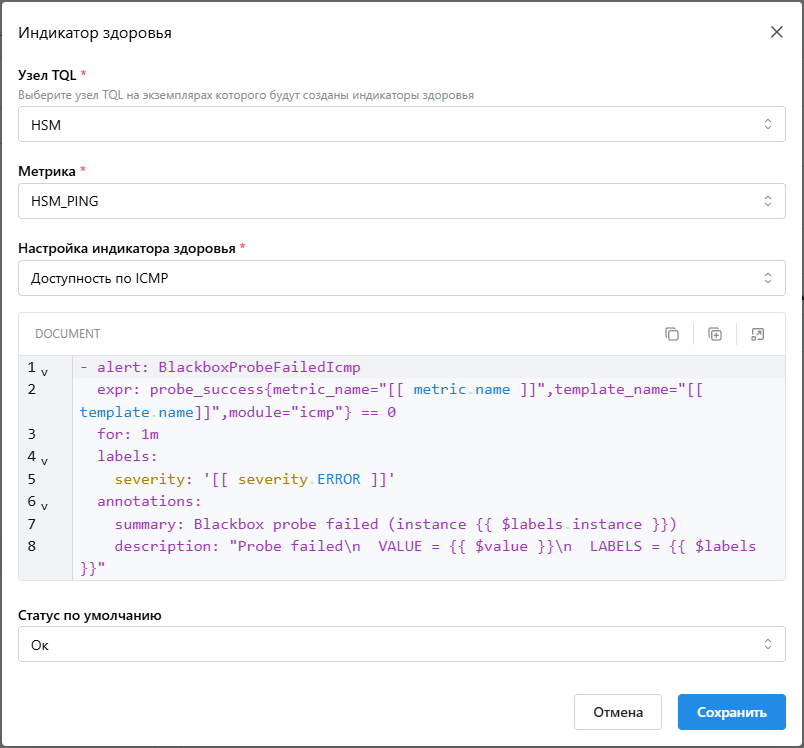
Индикатор метрики требует обязательного указания метрики, созданной в текущем шаблоне мониторинга. Метрика должна включать
лейбл ci_id. Лейбл ci_id используется для сопоставления алертов с КЕ. Если лейбл ci_id будет отсутствовать алерт не сможет
привязаться к КЕ.
При настройке ИЗ должны быть указаны:
- Узел TQL - Узел TQL к экземплярам которого будут привязаны индикаторы здоровья
- Индикатор здоровья - Название индикатора здоровья из реестра
- Метрика - Метрика, определенная в текущем шаблоне мониторинга
- Правило алертинга - Описание условия для срабатывания алерта
- Критичность по умолчанию - Уровень критичности, который приобретет индикатор здоровья в случае отсутствия алерта
Область применения
Индикаторы метрик предназначены для оценки состояния атомарных объектов — объектов мониторинга, которые не требуют декомпозиции на составные части.
Пример использования
Сетевое устройство может рассматриваться в двух вариантах:
Как единый объект
В этом случае устройство оценивается целиком, без разделения на компоненты.
- Метрики собираются для всего устройства.
ci_idсоответствует самому устройству.- Индикаторы метрик корректно отражают состояние устройства.
С декомпозицией на компоненты
Если устройство разбито на составные части (например, интерфейсы), индикаторы метрик не подходят для оценки состояния отдельных компонентов.
- Метрики могут собираться через одну точку интеграции, но привязаны к
ci_idустройства, а не его компонентов. - Индикаторы метрик не могут быть использованы для интерфейсов, так как отсутствует связь по
ci_id.
Ограничения
- Индикаторы метрик не поддерживают декомпозицию объекта мониторинга.
- Если требуется оценивать состояние подкомпонентов (например, интерфейсов, дисков, сервисов), необходимо использовать
- Индикатор метрики (ci_hint), обеспечивающие связь метрик без использования
ci_id.
Индикатор метрики (ci_hint)
Индикатор метрики — позволяет оценивать состояние КЕ на основе метрики.
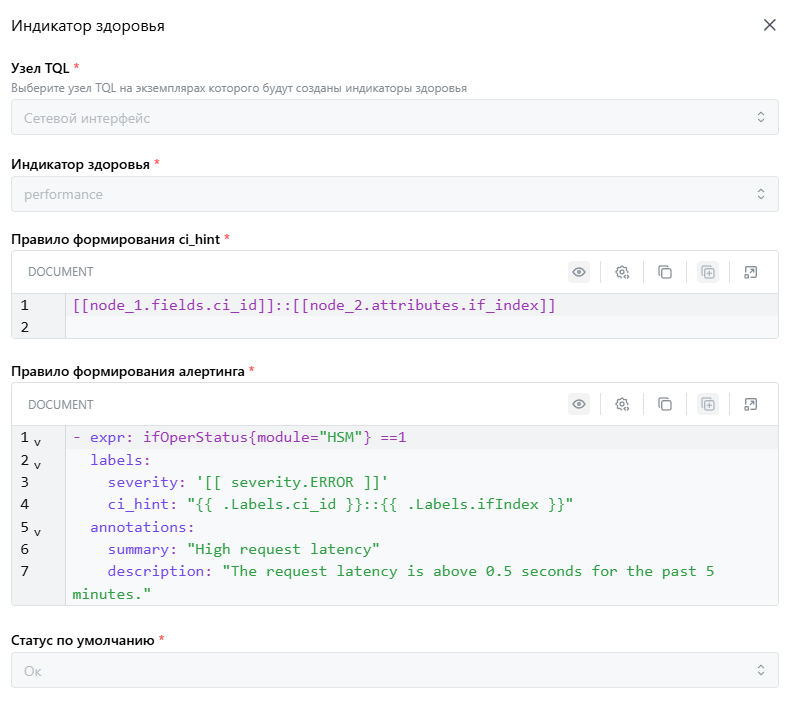
Индикатор рассчитан на привязку алертов, которые не содержат ci_id. Для привязки алерта к КЕ
нужно ввести альтернативный параметр ci_hint, по которому будет выполняться привязка.
При настройке ИЗ должны быть указаны:
- Узел TQL - Узел TQL к экземплярам которого будут привязаны индикаторы здоровья
- Индикатор здоровья - Название индикатора здоровья из реестра
- Метрика - Метрика, определенная в текущем шаблоне мониторинга
- Правило генерации
ci_hint- правило формирования уникальной строки, идентифицирующей КЕ - Правило алертинга - Описание условия для срабатывания алерта
- Критичность по умолчанию - Уровень критичности, который приобретет индикатор здоровья в случае отсутствия алерта
Общее о ci_hint
ci_hintэто строкаci_hintсуществует на стороне алерта, представляет собой label, значение которого формируется в момент формирования события агентом обработки правилci_hintсуществует на стороне индикатора здоровья
Генерация ci_hint в ИЗ
В ИЗ должен быть введен шаблон формирования ci_hint. Шаблон должен описывать правила формирования
строки, оперируя знаниями о КЕ доступных в ШМ, их связанности, их атрибутах и полях. Шаблон формирования ci_hint в значительной
степени похож на шаблон формирования таргета для метрики.
Пример:
[[node_1.attributes.name]]::[[node_2.attributes.name]]
ci_hint должен обновляться по факту:
- изменения структуры СРМ
- изменения TQL ШМ
- изменения атрибутов КЕ, участвующих в разрешении шаблона
ci_hint должен записываться в отдельную колонку his_composite. Поиск КЕ для пришедшего алерта должен осуществляться
по alertname И ci_hint.
Генерация ci_hint в правиле алертинга
Пример:
groups:
- name: example
  rules:
    - alert: HighRequestLatency
      expr: job:request_latency_seconds:mean5m{job="myjob"} > 0.5
      for: 10m
      labels:
        severity: '[[ severity.CRITICAL ]]'
        ci_hint: "{{ .Labels.job }}::{{ .Labels.instance }}"
      annotations:
        summary: "High request latency"
        description: "The request latency is above 0.5 seconds for the past 5 minutes."
Статус КЕ (static)
Статус КЕ — позволяет показать состояние КЕ, которое следует из её конфигурации в CMDB, а не из собираемых данных. Метрика и правило алертинга такому индикатору не нужны: статус задаётся прямо в привязке и одинаков для всех экземпляров КЕ выбранного узла TQL. Алерты по такому индикатору не создаются.
При настройке ИЗ должны быть указаны:
- Узел TQL - Узел TQL к экземплярам которого будут привязаны индикаторы здоровья
- Индикатор здоровья - Название индикатора здоровья из реестра
- Статус - Значение, которое примут индикаторы здоровья на всех экземплярах КЕ узла
В поле «Статус» доступны все состояния индикатора: Нет данных, Ок, Предупреждение, Ошибка,
Критический, Обслуживание. Состояния Ок—Критический соответствуют
уровням критичности 2—5.
Как меняется состояние КЕ
Статус, заданный в привязке, постоянный. Меняется не он, а состав узла TQL: индикаторы создаются на тех КЕ, которые узел возвращает, и снимаются с тех, которые из него выпали. Поэтому состояние КЕ меняют изменение TQL шаблона мониторинга и изменение атрибутов КЕ, участвующих в условиях узла.
Пример использования
Состояние VPN-туннеля хранится в CMDB атрибутом КЕ. В TQL шаблона заводятся два узла одного ТКЕ, различающиеся условием, и на каждый привязывается статический индикатор одного и того же типа:
| Узел TQL | Условие узла | Статус |
|---|---|---|
| Туннель ID: 1 | туннель выключен | Ошибка |
| Туннель ID: 2 | туннель включён | Ок |
Пока туннель выключен, КЕ попадает в первый узел и получает индикатор со статусом Ошибка. После включения
туннеля КЕ уходит из первого узла во второй: индикатор первой привязки закрывается, индикатор второй
создаётся со статусом Ок. На здоровье КЕ это выглядит как смена состояния.
Условия узлов должны быть взаимоисключающими. Система не запрещает привязать статические индикаторы одного типа к нескольким узлам, и если КЕ попадёт сразу в два таких узла, на ней окажутся два индикатора одного типа с разными статусами.
Статус меняется только у выключенной привязки: у включённой поля формы недоступны, а изменение через API отклоняется. Чтобы назначить другой статус, привязку нужно выключить, изменить и включить снова — новое значение применится при включении.
Область применения
- Состояние, которое целиком определяется конфигурацией КЕ и не требует сбора данных.
- Постоянное слагаемое расчётного индикатора: статический индикатор может быть его источником наравне с индикаторами остальных типов.
Событие (event)
Событие — позволяет вести состояние КЕ событиями из внешней системы. Метрика и правило алертинга такому индикатору не нужны: Памир не порождает такие события сам, а принимает их готовыми — например, от монитора OpenSearch.
При настройке ИЗ должны быть указаны:
- Узел TQL - Узел TQL к экземплярам которого будут привязаны индикаторы здоровья
- Индикатор здоровья - Название индикатора здоровья из реестра
- Правило формирования
ci_hint- правило формирования уникальной строки, идентифицирующей КЕ hi_hint- строка, по которой событие находит эту привязку- Статус по умолчанию - Уровень критичности, который приобретет индикатор здоровья в случае отсутствия события
ci_hint устроен так же, как у индикатора метрики (ci_hint): это шаблон,
который разрешается в строку по атрибутам и полям КЕ, см.
использование ссылок на КЕ.
hi_hint, в отличие от ci_hint, не шаблон, а постоянная строка: она сравнивается со значением одноимённой
метки события целиком.
hi_hint не обязан быть уникальным. Если одно и то же значение указано у нескольких включённых привязок, в
том числе в разных шаблонах мониторинга, пришедшее событие обновит индикаторы всех этих привязок.
Приём событий
События принимает сервис мониторинга. Авторизация для этих запросов не требуется.
| Запрос | Тело | Заголовок Content-Type |
|---|---|---|
POST /api/monitoring/v4/api/v2/alerts | массив JSON | application/json |
POST /api/monitoring/v4/api/v2/alerts_yaml | список YAML | application/x-yaml или application/yaml |
POST /api/monitoring/v4/api/v2/alerts/{имя_агента} | массив JSON | application/json |
Префикс /api/monitoring задаётся параметром ROOT_PATH в
настройках сервиса мониторинга.
Первые два запроса отличаются только форматом тела. Вариант с YAML добавлен ради шаблонизатора событий OpenSearch: он не умеет расставлять запятые между объектами, и собрать из результатов монитора корректный массив JSON не получается. В списке YAML элементы разделяются дефисами, запятые не нужны.
Третий запрос принимает те же события, но применяет к ним настройки дедупликации
агента обработки правил, имя которого указано в адресе. Настройки задаются в форме агента на
странице Главная / Настройки / Мониторинг / Агенты обработки правил:
- Группировка по лейблам — для сравнения событий останутся только перечисленные метки;
- Игнорируемые лейблы — перечисленные метки будут вырезаны перед сравнением.
Так внешний источник может управлять тем, что считать повторением события, не подбирая для этого состав меток. Настройки применяются ко всем событиям, пришедшим на этот адрес, независимо от того, связана ли привязка индикатора с этим агентом. Если агента с таким именем нет, события принимаются, а настройки не применяются.
Тело запроса — список событий. Поля события:
| Поле | Обязательное | Описание |
|---|---|---|
startsAt | да | Время возникновения события. |
labels | да | Метки события, см. ниже. Событие без меток отбрасывается. |
annotations | да | Объект с полями summary и description, оба могут быть пустыми. |
generatorURL | да | Значение произвольное: система его сохраняет, но не использует. |
endsAt | нет | Время, после которого состояние снимается. |
repeatable | нет | Признак того, что источник повторяет событие. |
repeat_interval | нет | Период повторения, например 5m. Учитывается при repeatable: true. |
Метки события:
| Метка | Обязательная | Описание |
|---|---|---|
hi_hint | да | Значение поля hi_hint привязки — по нему событие находит привязку. |
ci_hint | да | Значение ci_hint КЕ — по нему событие находит индикатор на конкретной КЕ. |
severity | да | Уровень критичности от 2 до 5. |
Событие, в котором нет hi_hint, нет ci_hint или severity выходит за пределы 2—5, отбрасывается:
индикатор остаётся в прежнем состоянии. Метка ci_id для этого типа не используется — индикатор ищется
по ci_hint.
Остальные метки события произвольны, но они участвуют в различении событий: события с одинаковым набором
меток считаются одним и тем же событием, и повторное обновляет уже открытое, а не добавляет новое. В набор
входит и severity, поэтому событие, присланное с другим уровнем критичности, будет новым, а прежнее
останется открытым, пока не будет снято.
Пример тела в формате YAML:
- startsAt: "2026-06-24T10:15:00.000Z"
  generatorURL: "https://opensearch.example/app/alerting"
  labels:
    hi_hint: vpn_tunnel_down
    ci_hint: "msk-gw-01::tun0"
    severity: 4
  annotations:
    summary: "Туннель tun0 не поднялся"
    description: "За последние 5 минут не было успешных согласований"
- startsAt: "2026-06-24T10:15:00.000Z"
  generatorURL: "https://opensearch.example/app/alerting"
  labels:
    hi_hint: vpn_tunnel_down
    ci_hint: "spb-gw-02::tun0"
    severity: 4
  annotations:
    summary: "Туннель tun0 не поднялся"
    description: "За последние 5 минут не было успешных согласований"
Снятие состояния
Пока событие открыто, индикатор держит его уровень критичности. После снятия события индикатор возвращается к статусу по умолчанию.
Со стороны источника снять состояние можно тремя способами:
- прислать то же событие — с тем же набором меток — указав
endsAtв прошлом: оно будет снято сразу при приёме; - указать
endsAtв будущем: система снимет состояние сама, когда это время наступит; - указать
repeatable: trueиrepeat_interval: срок жизни события отсчитывается отstartsAtи продлевается каждым повторением, поэтому состояние снимется само, как только источник перестанет повторять событие.
Поле status в теле запроса на снятие не влияет: система ориентируется только на время.
Ручное закрытие
Событие можно закрыть и вручную: на странице СРМ, вкладка Здоровье КЕ, в разборе причины состояния
индикатора у карточки события есть кнопка «Закрыть событие».
В отличие от приёма событий, закрытие требует авторизации и прав на индикатор: если нет доступа к типу индикатора здоровья или к КЕ, запрос отклоняется. Результат тот же, что у автоматического снятия — индикатор возвращается к статусу по умолчанию, — но в истории дополнительно остаётся, кто закрыл событие.
Кнопка появляется только у события, присланного без endsAt. Событие с endsAt, равно как и событие с
repeatable: true и repeat_interval, закрывается по времени, и вручную его закрыть нельзя — кнопки у
такого события нет.
Расчетный индикатор
Использование ссылок на КЕ в шаблонизаторе ci_hint
Общий вид ссылки:
<узел_tql>.<ключевое_слово>.<название_атрибута_или_поля>
<узел_tql> идентифицируется номером. Номер - натуральное число > 0. Для упрощения восприятия пользователем к номеру
узла добавляется название ТКЕ. Итоговый вид узла TQL: <название_ТКЕ>_<номер_ноды_в_tql>. <узел_tql> может быть не
указано.
<ключевое_слово> - строковый литерал, принимающий одно из значений (перечень значений может быть расширен):
attributes: используется для адресации к атрибутам ТКЕfields: используется для адресации к системным полям ТКЕ
<название_атрибута_или_поля> - название атрибута ТКЕ или системного поля ТКЕ. Перечень названий атрибутов - не ограничен,
определяется исходя из привязанных к ТКЕ атрибутов.
Перечень системных полей:
ci_idci_nameci_type_name